记录复盘:RecordManager 为什么要保存 pre、record、post 和 scan
解释 RespiraScope 的记录系统为什么不只保存用户点击 Start 到 End 的区间,而要保留前后辅助点、扫描子区间和离线复算结果。
背景问题
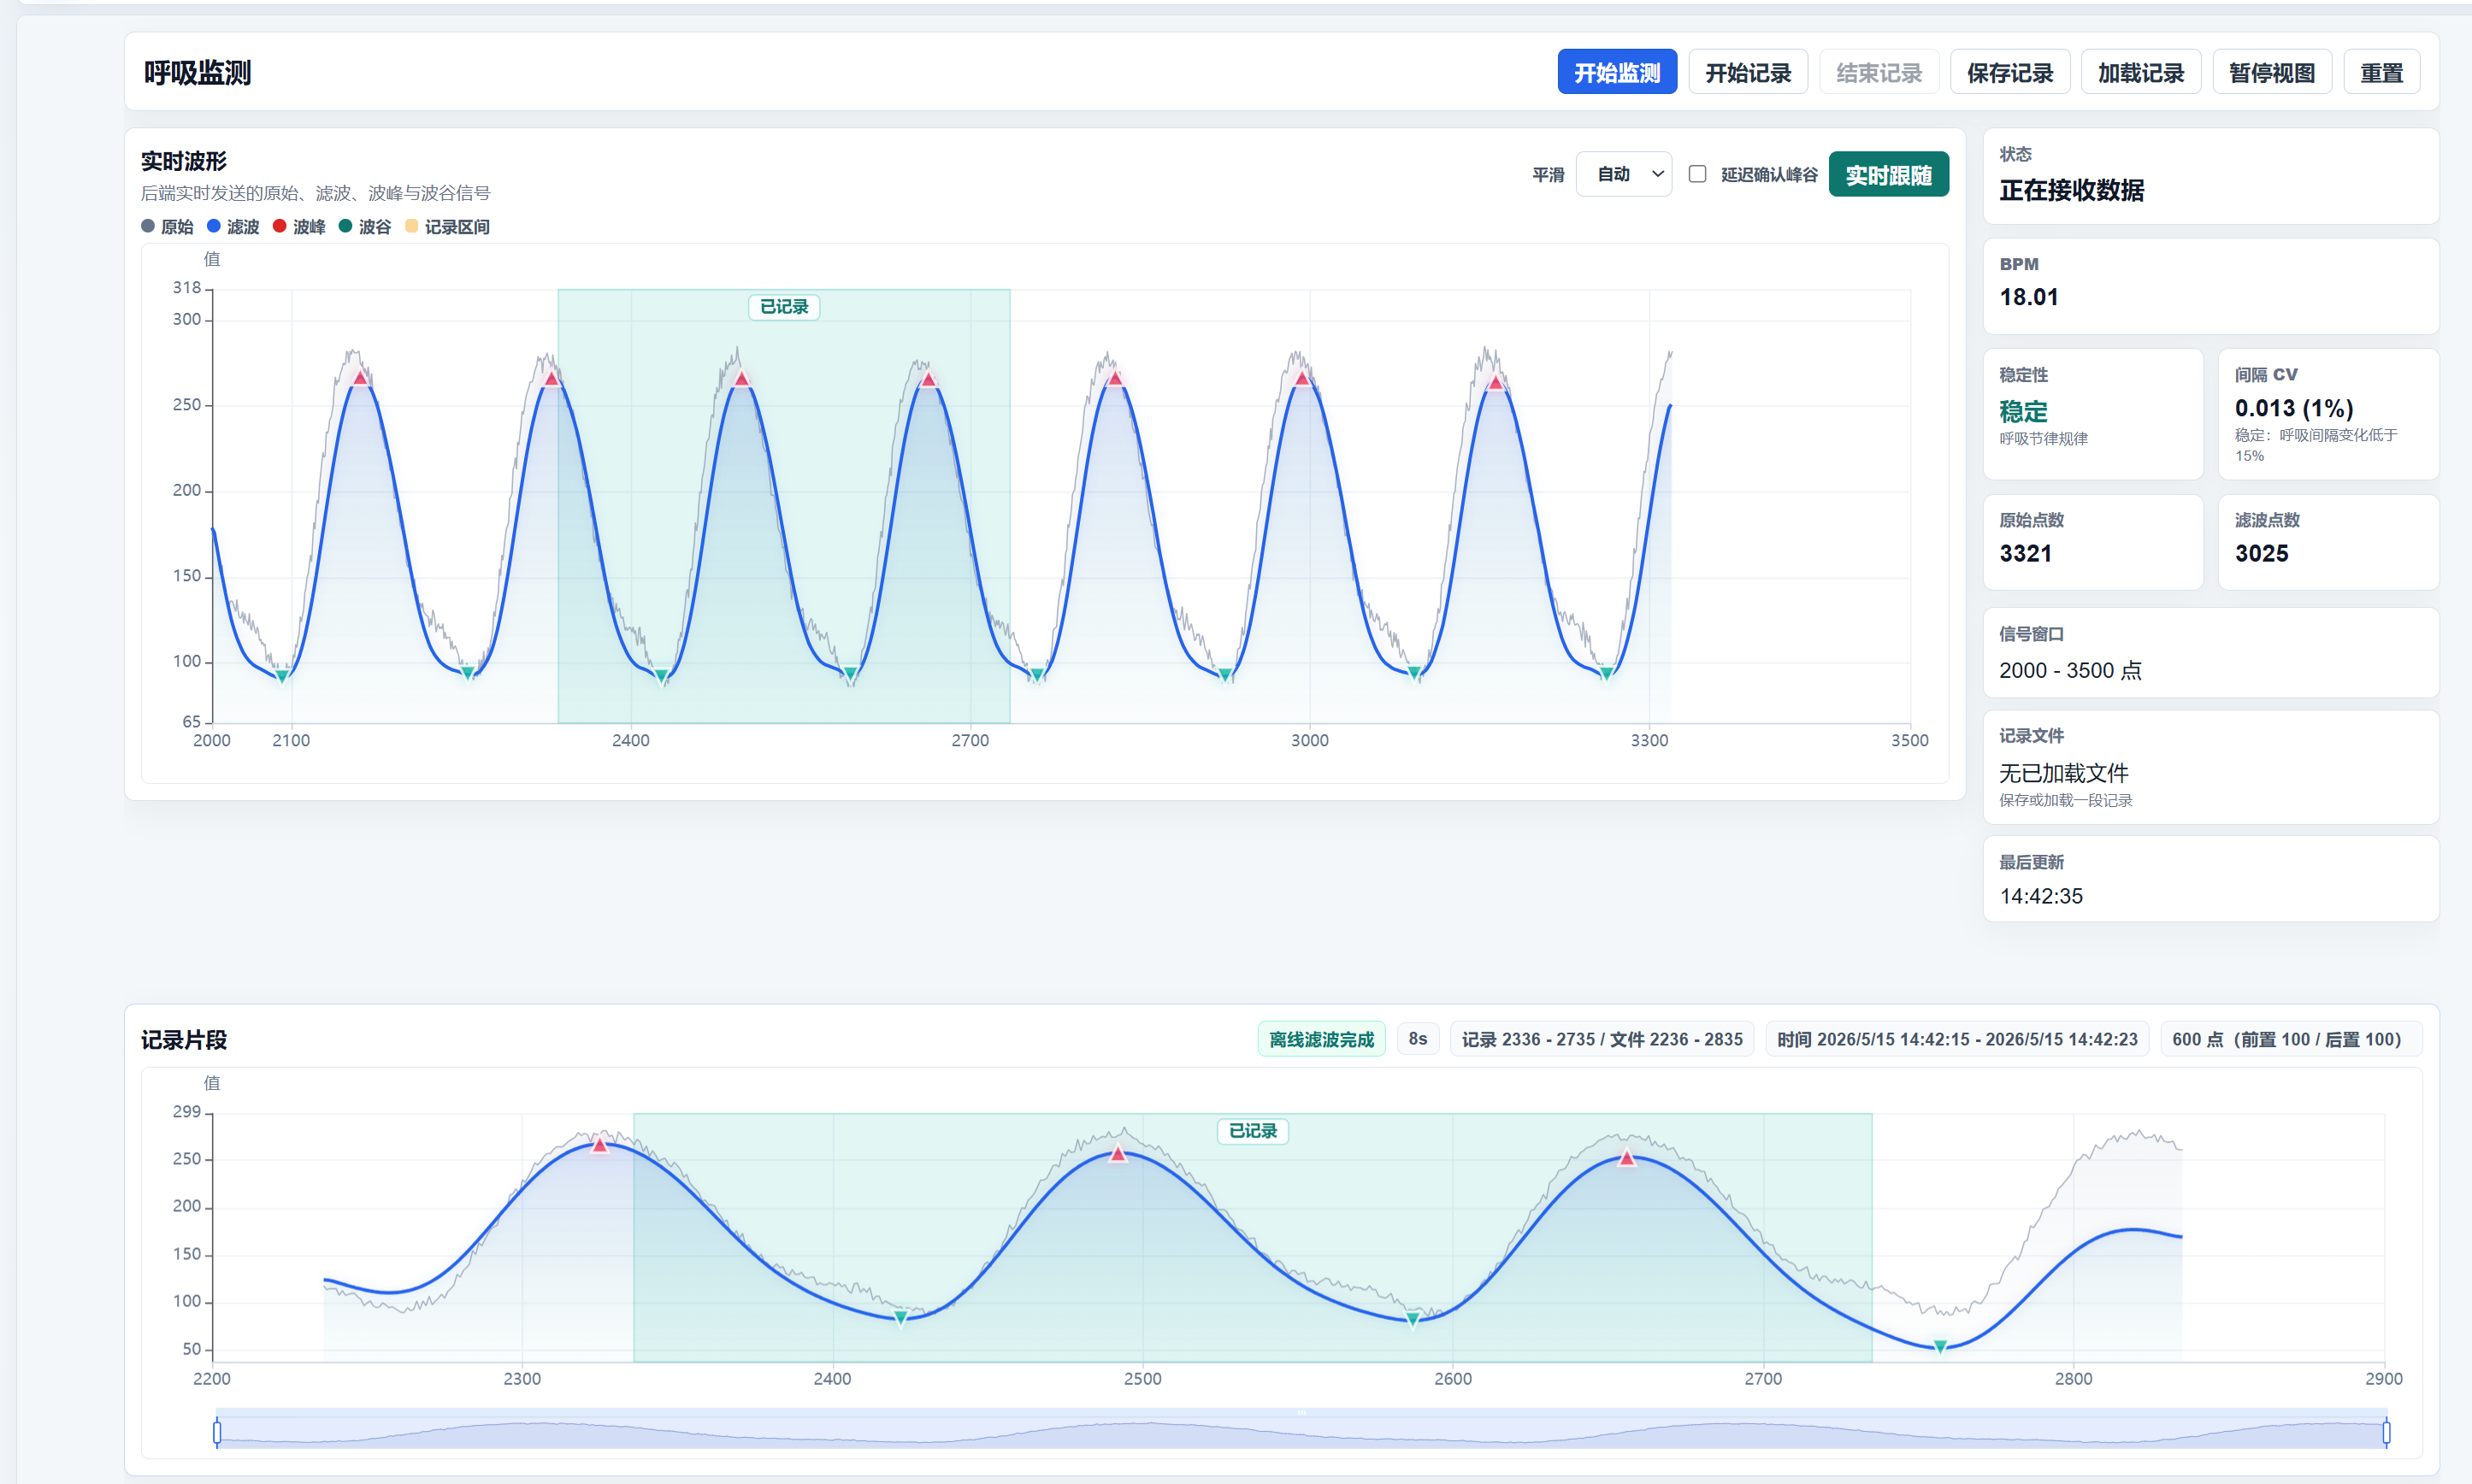
实时监测页面能告诉你“现在发生了什么”,但工程调试经常还需要复盘“刚才那一段为什么这样”。比如一段扫描期间出现咳嗽,实时 BPM 变乱;或者 Record End 后发现峰谷标记偏晚,需要用离线滤波重新判断。
如果记录系统只保存用户点击 Record Start 到 Record End 中间的点,会出现两个问题:离线滤波缺少边界上下文,扫描子区间也无法和完整记录区分。RespiraScope 的 RecordManager 因此把记录拆成 pre、record、post 和 scan。
设计方案对比
| 方案 | 优点 | 问题 | 项目判断 |
|---|---|---|---|
| 只保存 Start 到 End | 文件小,逻辑简单 | 离线滤波边界不稳定,缺少上下文 | 不够可靠 |
| 保存全程实时数据 | 信息完整 | 文件大,用户真正记录区间不清楚 | 不适合交互复盘 |
| 保存记录区间 + 前后辅助点 | 文件可控,滤波上下文足够 | 数据结构更复杂 | 当前采用 |
| 直接保存截图 | 最直观 | 不能重新滤波、不能集成、不能计算指标 | 只适合展示 |
当前方案的核心是:用户关心的记录范围和算法需要的计算上下文不是同一个范围。把它们区分开,后续分析才不会混乱。
当前方案
RecordManager 维护四类缓存:
raw_pre_buffer、filter_pre_buffer、peak_pre_buffer、valley_pre_buffer:记录开始前的辅助缓存。raw_record_queue、filter_record_queue:实际捕获的记录数据。peak_record_queue、valley_record_queue:记录期间的实时事件。scans和active_scan:用户在记录期间标注的扫描子区间。
当用户点击 record/start,后端会把开始前的 pre_points 拷进记录队列。点击 record/end 后,后端继续等待 post_points,再做离线滤波。
为什么这样选
离线滤波需要上下文。Butterworth 双向滤波和 Gaussian 平滑都受边界影响。如果只把用户选择区间拿去滤波,Start 附近和 End 附近的结果更容易失真。pre_points 和 post_points 的作用就是给离线滤波提供缓冲,但保存结果时仍能标明哪些点只是辅助。
scan 的设计解决另一个问题:一次记录里可能有多个业务动作,比如多次扫描、咳嗽标注或设备操作。scan 不应该拆成多个 record,因为完整呼吸上下文仍然有价值;也不应该只靠前端颜色标记,因为保存文件和外部系统也需要知道 scan 范围。
记录结束为什么直接离线复算
早期设计可以让前端拿到记录数据后再调用 /applyFilter。现在 /record/end 会直接等待 post 辅助点,并返回本次记录的离线滤波结果。这减少了前端编排复杂度,也避免外部系统忘记携带辅助点。
/applyFilter 仍然保留,用于外部系统对任意历史 raw_data 做离线复算。也就是说:
| 接口 | 适合用途 |
|---|---|
/record/end | 当前正在进行的记录结束,并返回本次离线结果 |
/applyFilter | 外部系统已有历史数据,想单独复算 |
/record/save | 把当前完整记录写入 JSON 文件 |
代价和边界
记录结构比简单数组复杂。保存文件里会有 segments、scans、scan_indexes、record_start_sequence、capture_start_sequence 等字段。复杂度是有意引入的,因为它换来的是复盘时的可解释性。
当前记录仍然是内存缓存,不是长期数据库。MAX_RAW_RECORD_POINTS 和 MAX_MARKER_RECORD_POINTS 对记录长度有保护,适合分钟级片段,不适合作为全天候连续归档系统。
关键函数表
| 函数或类 | 作用 | 设计点 |
|---|---|---|
RecordManager.start_record() | 开始记录并拷贝 pre buffer | 明确记录区间和捕获区间 |
RecordManager.stop_record() | 结束用户记录区间并进入 post 捕获 | 为离线滤波补上下文 |
RecordManager.start_scan() | 开始扫描子区间 | 允许一次记录中标注多个业务片段 |
annotate_points() | 给点标注 segment 和 scan_indexes | 保存文件可直接解释每个点 |
raw_points_for_filter() | 提取可离线滤波的 raw 点 | 避免把元数据混入算法输入 |
BreathProcessSystem.stop_record_and_filter() | 结束记录并离线复算 | 后端统一完成复盘逻辑 |
write_file() | 写 JSON 文件 | 使用 UTF-8 和缩进,便于人工检查 |
读源码建议
读 record_manager.py 时先看三个状态:recording、post_recording、record_complete。然后看 start_record() 和 stop_record(),理解 record_start_sequence 与 capture_start_sequence 的区别。最后看 build_record_data(),它决定了保存文件和 /record/end 结果为什么有这些字段。