总览:RespiraScope 的系统边界与设计取舍
从项目定位、整体架构和核心取舍开始,理解 RespiraScope 为什么被设计成一个后端采集处理服务加 Web Console 的实时信号系统。
背景问题
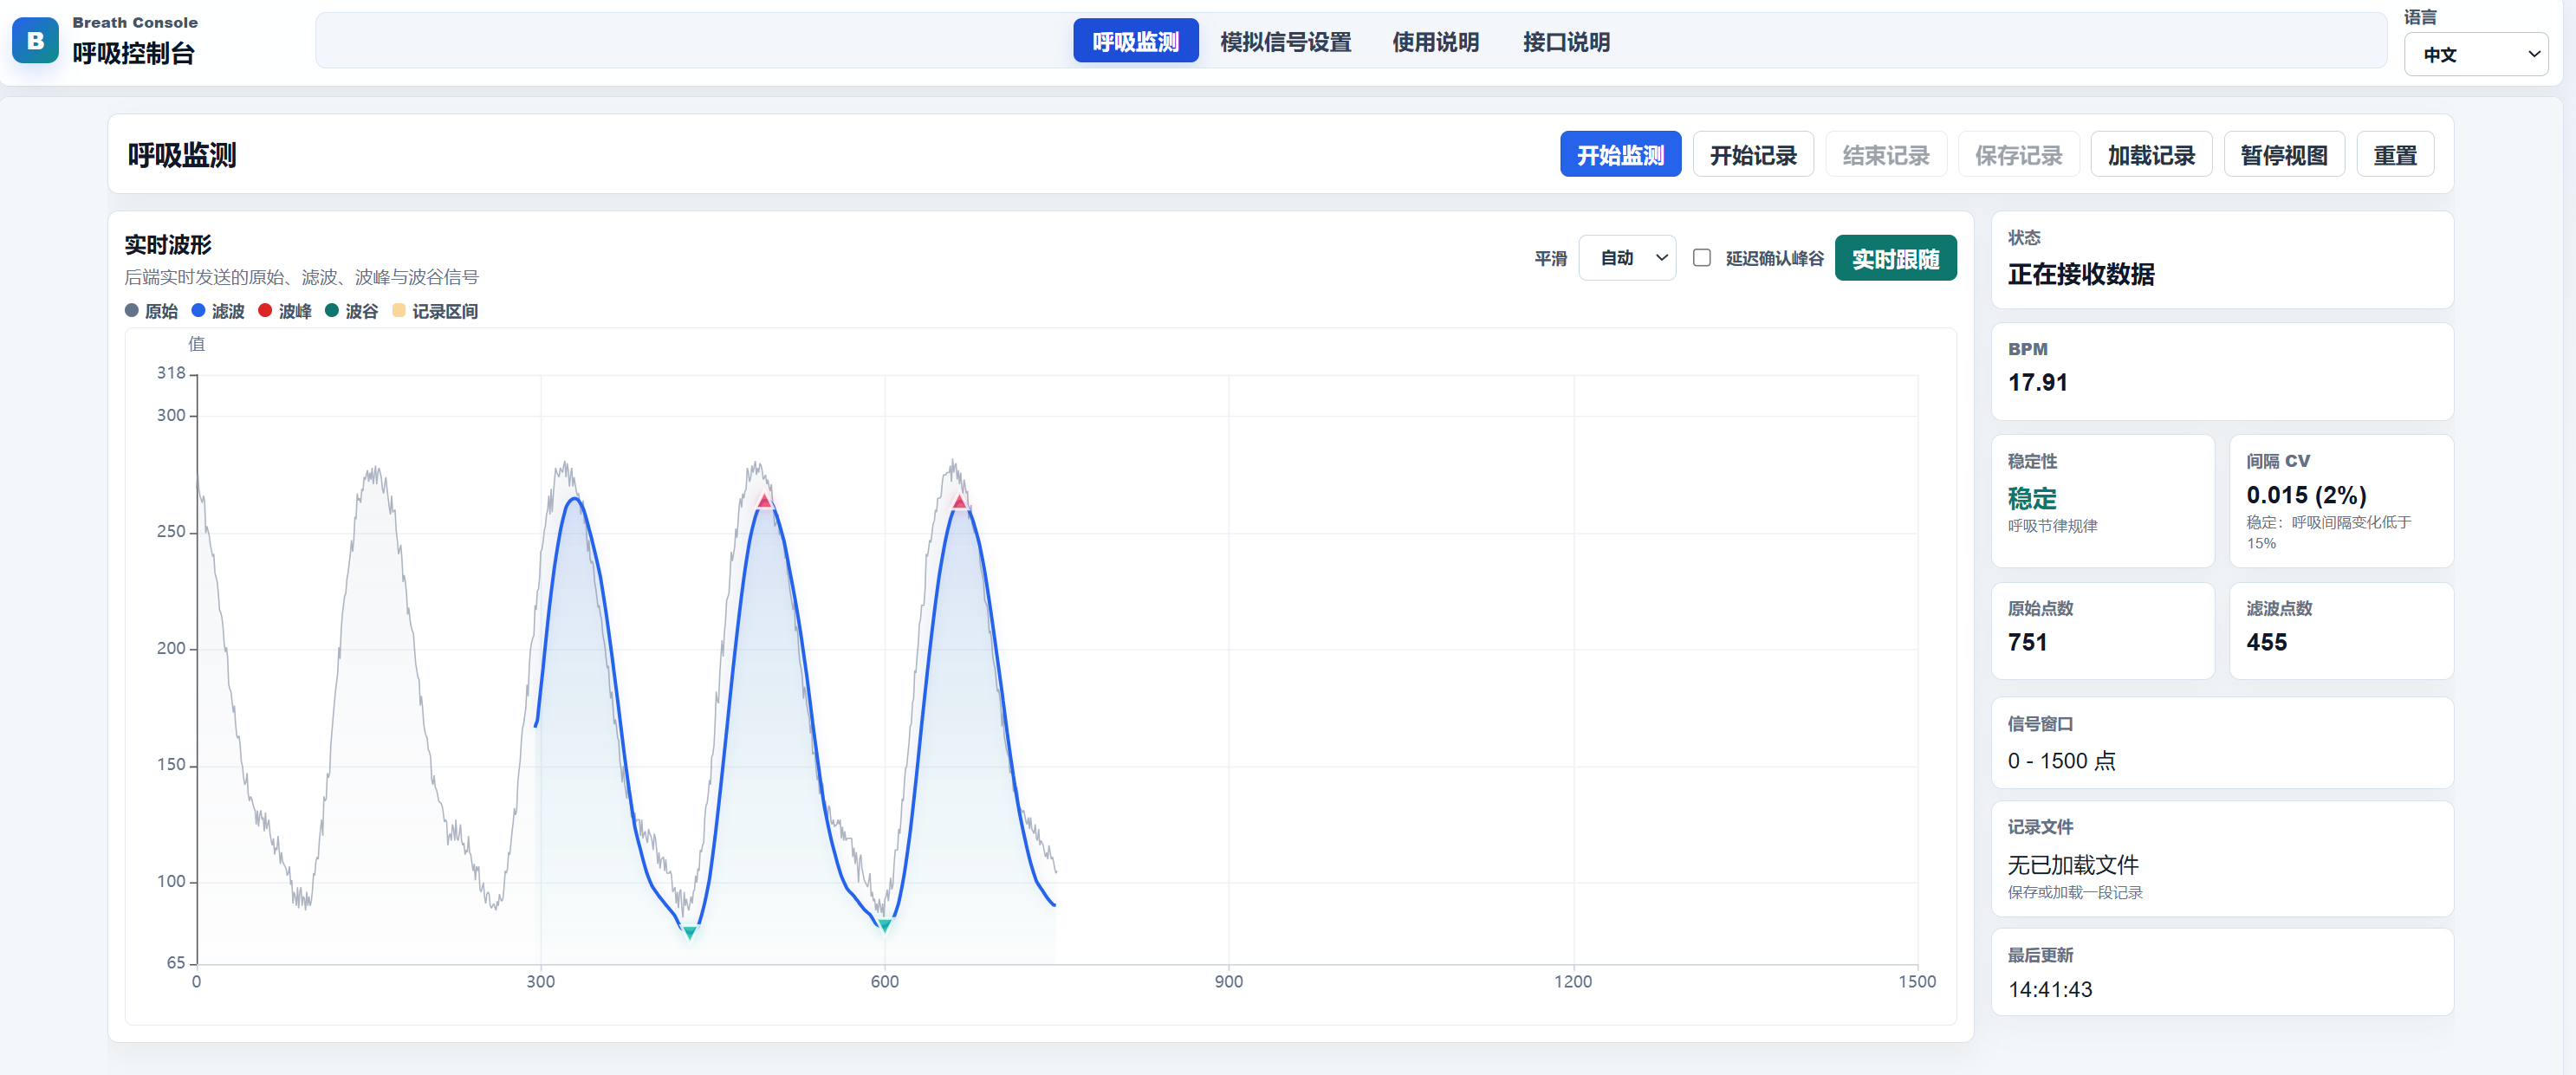
RespiraScope 要解决的不是“画一条曲线”这么简单。真实问题是:呼吸传感器不断输出 TCP 采样点,后端要给每个点编号、实时滤波、识别波峰波谷、计算 BPM 和稳定性,同时把原始数据、滤波数据、事件、指标、记录片段推给 Web Console 和外部系统。
这类系统最容易失控的地方有三个:实时链路会被 UI 和算法耦合在一起,滤波逻辑会被“实时显示”和“离线复盘”互相污染,记录文件会只保存一段波形而丢失上下文。RespiraScope 的设计重点就是把这些边界拆开。
设计方案对比
| 方案 | 优点 | 问题 | 适合场景 |
|---|---|---|---|
| 单脚本 Demo | 上手最快,几百行代码就能读 TCP、滤波、画图 | 难测试,难复用,前端和算法耦合,异常状态难解释 | 一次性课堂演示 |
| 纯前端处理 | UI 交互灵活,部署简单 | 浏览器不适合直接接真实 TCP 设备,SciPy 算法不可直接复用 | 已有 WebSocket 数据源的轻量展示 |
| 后端服务 + Web Console | 采集、算法、API、UI 边界清楚,外部系统也能接入 | 需要维护 HTTP、Socket.IO、静态前端和配置 | RespiraScope 当前目标 |
| 桌面一体化商业工具 | 用户体验完整,可管控环境 | 打包、升级、日志、设备适配复杂度更高 | 长期交付型产品 |
RespiraScope 选择“后端服务 + Web Console”,原因是它既要服务自己的 Monitor 页面,也要给外部业务系统留出集成入口。后端负责最稳定的部分:设备连接、滤波、识别、记录和协议;前端负责展示、交互、回看和参数调整。
当前方案
项目核心链路由 BreathProcessSystem 装配。它创建 DataReceiver、SignalProcessor、PeakValleyDetector、RecordManager、DataQueueManager、DataSender 和 SignalQualityAnalyzer。这些对象不是靠一个巨大的循环彼此调用,而是通过小的 handler 接口串起来。
<rect x="282" y="50" width="190" height="128" rx="16" fill="var(--surface)" stroke="var(--line)" />
<text x="377" y="85" text-anchor="middle" fill="currentColor" font-weight="800">后端实时服务</text>
<text x="377" y="112" text-anchor="middle" fill="var(--muted)" font-size="13">FastAPI</text>
<text x="377" y="136" text-anchor="middle" fill="var(--muted)" font-size="13">SignalProcessor</text>
<text x="377" y="160" text-anchor="middle" fill="var(--muted)" font-size="13">PeakValleyDetector</text>

<rect x="545" y="50" width="180" height="128" rx="16" fill="var(--surface)" stroke="var(--line)" />
<text x="635" y="85" text-anchor="middle" fill="currentColor" font-weight="800">数据出口</text>
<text x="635" y="112" text-anchor="middle" fill="var(--muted)" font-size="13">HTTP 控制面</text>
<text x="635" y="136" text-anchor="middle" fill="var(--muted)" font-size="13">Socket.IO 数据面</text>
<text x="635" y="160" text-anchor="middle" fill="var(--muted)" font-size="13">JSON 记录文件</text>

<rect x="790" y="72" width="150" height="84" rx="14" fill="var(--surface)" stroke="var(--line)" />
<text x="865" y="107" text-anchor="middle" fill="currentColor" font-weight="800">消费者</text>
<text x="865" y="132" text-anchor="middle" fill="var(--muted)" font-size="13">Console / 外部系统</text>

<path d="M210 114 H270" stroke="var(--accent)" stroke-width="2.5" marker-end="url(#arrow-rs-overview)" />
<path d="M472 114 H533" stroke="var(--accent)" stroke-width="2.5" marker-end="url(#arrow-rs-overview)" />
<path d="M725 114 H778" stroke="var(--accent)" stroke-width="2.5" marker-end="url(#arrow-rs-overview)" />

<rect x="282" y="252" width="190" height="92" rx="16" fill="var(--surface)" stroke="var(--line)" />
<text x="377" y="288" text-anchor="middle" fill="currentColor" font-weight="800">记录复盘</text>
<text x="377" y="315" text-anchor="middle" fill="var(--muted)" font-size="13">pre / record / post</text>

<rect x="545" y="252" width="180" height="92" rx="16" fill="var(--surface)" stroke="var(--line)" />
<text x="635" y="288" text-anchor="middle" fill="currentColor" font-weight="800">模拟与异常</text>
<text x="635" y="315" text-anchor="middle" fill="var(--muted)" font-size="13">可重复调试场景</text>

<path d="M377 178 V240" stroke="var(--accent)" stroke-width="2.5" marker-end="url(#arrow-rs-overview)" />
<path d="M635 178 V240" stroke="var(--accent)" stroke-width="2.5" marker-end="url(#arrow-rs-overview)" />
软件结构可以按职责读:
| 层次 | 关键代码 | 责任 |
|---|---|---|
| 启动与配置 | config.py、main.py、frontend_static.py | 读取外部 TOML,启动后端和统一 Web Console |
| 采集输入 | socket_client.py、data_receive.py、mock_sensor/* | 连接真实或模拟 TCP 传感器,生成 sequence |
| 实时处理 | signal_processor.py、filter_strategies.py | 滑动窗口滤波,区分实时与离线策略 |
| 事件识别 | peak_valley_detector.py、signal_quality.py | 峰谷、BPM、稳定性、异常质量事件 |
| 记录复盘 | record_manager.py | 保存记录区间和前后辅助上下文 |
| 通信出口 | http_service.py、socket_io_service.py、send_to_client.py | HTTP 控制、Socket.IO 推送、记录保存 |
| Web Console | frontend-console、frontend-monitor、frontend-lab | 实时监测、模拟设置、记录回看 |
为什么这样选
第一,实时系统必须能解释时间顺序。项目给每个 raw 点分配递增 sequence_number,后续 filtered、peak、valley、record、scan 都靠同一条序号轴对齐。相比只靠时间戳,sequence 更适合判断断流、补齐、回放和前端图表对齐。
第二,实时显示和复盘分析目标不同。实时滤波要低延迟,允许轻微相位滞后;离线滤波要更平滑、更准确,可以使用完整片段和双向滤波。把两者做成 RealtimeFilterStrategy 和 OfflineFilterStrategy,比在一个函数里塞很多分支更容易解释。
第三,项目保留 HTTP 和 Socket.IO 两种接口。HTTP 适合“开始接收、停止接收、开始记录、保存记录”这类明确命令;Socket.IO 适合 40ms 一批的实时数据。全部用 HTTP 会变成高频轮询,全部用 Socket 又会让控制命令和错误响应难以规范。
代价和边界
这个设计不是诊断级临床系统。它没有权限审计、医疗设备认证、长期数据归档,也没有对所有传感器协议做抽象。它更适合设备联调、算法验证、教学、演示和小规模工程集成。
当前设计也不是最高性能架构。Python、FastAPI、Socket.IO 和浏览器图表足以支撑当前采样率和演示规模,但如果要处理多床位、多设备、高并发长期监测,就需要引入消息队列、持久化数据库、指标监控和更严格的服务拆分。
关键函数表
| 函数或类 | 作用 | 设计意义 |
|---|---|---|
create_socket_app() | 创建 Socket.IO ASGI 应用并挂载 FastAPI | 让 HTTP 和实时推送共用一个后端端口 |
BreathProcessSystem.start() | 更新滤波参数并启动 receiver task | 把启动流程收敛到一个生命周期入口 |
DataReceiver.data_handler() | 给采样点编号并分发给 handlers | 保证所有下游模块共享同一 sequence |
SignalProcessor.process_sliding_window() | 每次处理固定 step 的新数据 | 平衡延迟和计算成本 |
PeakValleyDetector.detect_peak_valley_batch() | 离线批量识别峰谷 | 给记录复盘提供更稳定的结果 |
RecordManager.build_record_data() | 组装记录文件结构 | 保存数据、区间、scan 和滤波结果的上下文 |
DataQueueManager.snapshot_messages() | 给新 Socket client 补发最近快照 | 页面刷新后不用从空图表开始等待 |
读源码建议
先读 BreathProcessSystem.__init__() 和 _setup_connections(),理解对象如何被装配。再读 start()、DataReceiver.data_handler()、SignalProcessor.process_sliding_window()、DataSender.start_sending(),就能顺着实时链路看到每个点如何从 TCP 进入浏览器。最后读 RecordManager,理解为什么一个记录文件不只是 raw 数组,而是带有前后辅助区间和 scan 标注的复盘对象。